Perché “AI on-premise” non dice tutto
Negli ultimi mesi, il numero di vendor che propongono soluzioni di AI on-premise a Studi Professionali, PMI e Pubbliche Amministrazioni italiane è cresciuto in modo significativo.
Il messaggio commerciale è quasi sempre lo stesso: “I vostri dati restano in azienda. Niente cloud. Niente rischi.“.
Ma dietro l’espressione “AI on-premise” — o le sue varianti “AI locale“, “LLM locale“, “intelligenza artificiale in ufficio” — si nascondono tre concetti tecnici e giuridici distinti, che i capitolati di gara e i contratti di fornitura devono trattare separatamente. Confonderli non è un errore accademico: è un rischio di compliance.
In questo articolo definiamo con precisione operativa:
- Residenza del dato
- Sovranità del dato
- Esecuzione on-premise (o esecuzione locale)
e mostriamo come tradurre queste definizioni in requisiti verificabili quando si valuta un’infrastruttura di intelligenza artificiale per il proprio contesto.
AI on-premise, AI locale e LLM locale: non sono sinonimi
Prima di entrare nei tre concetti, una premessa lessicale. Nel linguaggio commerciale italiano si usano indifferentemente:
- AI on-premise → soluzione di intelligenza artificiale installata e operante nell’infrastruttura del cliente.
- AI locale → termine più generico, talvolta usato per indicare un modello che gira su un dispositivo locale (laptop, workstation) senza connessione a un servizio cloud.
- LLM locale → Large Language Model eseguito su hardware locale, senza invio di prompt o output a un endpoint remoto.
- “Intelligenza artificiale in ufficio” → espressione colloquiale che copre qualsiasi deployment AI all’interno dei locali aziendali, dal chatbot su un server rack al modello su una GPU di un workstation.
Nessuna di queste espressioni, da sola, specifica dove avviene l’inferenza, sotto quale giurisdizione cadono i dati o chi ha accesso fisico e logico all’hardware. È proprio in questa zona grigia che si annida il rischio.
Residenza del dato: dove “dormono” i vostri dati
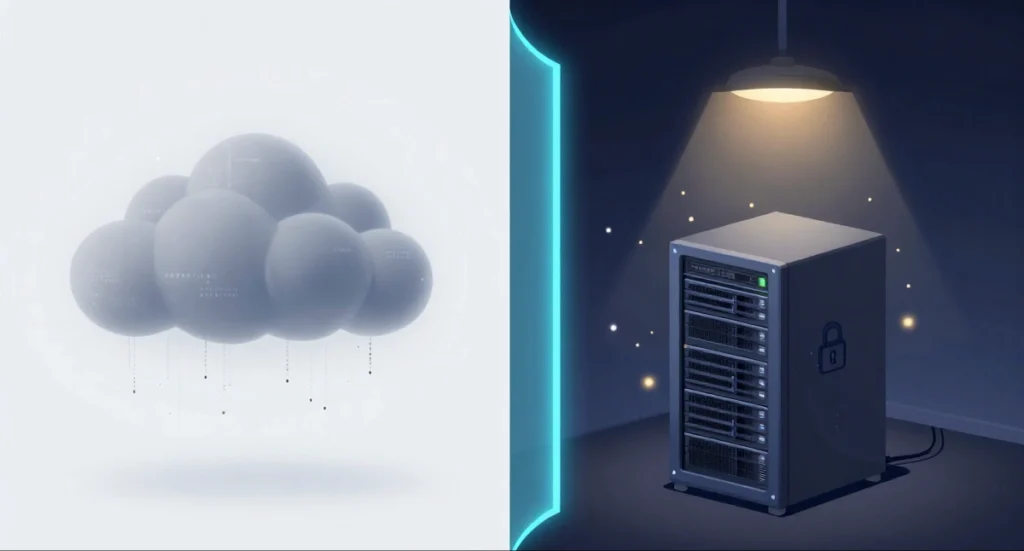
Definizione operativa -> la residenza del dato indica che i dati — input, output, log di inferenza, pesi del modello, prompt degli utenti — sono fisicamente memorizzati in un’area geografica definita. Tipicamente: un data center in un Paese UE, o in Italia.
Cosa NON implica -> la residenza del dato non garantisce che l’elaborazione avvenga nello stesso luogo. Un LLM ospitato in una cloud region europea (ad esempio AWS eu-west-1, Microsoft Azure West Europe) ha i dati “residenti” in UE, ma l’inferenza avviene su hardware del provider cloud, soggetto ai termini di servizio di quell’azienda e, potenzialmente, alla giurisdizione del Paese in cui il provider ha sede legale.
Esempio concreto -> uno Studio Legale che usa un assistente AI basato su un LLM in una cloud region italiana ha la residenza del dato in Italia. Tuttavia, se il provider cloud ha una holding negli Stati Uniti, il CLOUD Act USA può, in teoria, estendere la portata della richiesta di accesso a quei dati. La residenza, da sola, non risolve questo problema.
Come verificarla -> Nel contratto di fornitura o nel DPA (Data Processing Agreement) devono essere indicati:
- Il data center specifico (città, Paese).
- Il sub-processor che esegue l’inferenza.
- Le garanzie contro trasferimenti extra-UE (clausole contrattuali standard, decisione di adeguatezza).
Sovranità del dato: quando la giurisdizione conta più della geografia
Definizione operativa -> La sovranità del dato aggiunge alla residenza un requisito giuridico: il dato è soggetto esclusivamente alla legislazione di uno Stato membro o dell’Unione Europea e non è accessibile a autorità di Paesi terzi (Stati Uniti, Cina, ecc.) in assenza di un meccanismo di mutuo assistenza legale (MLAT) o di una decisione di adeguatezza.
Cosa implica in più rispetto alla residenza ->
- Garanzie contrattuali che il provider non cederà dati a richieste di intelligence straniere.
- Architettura tecnica che impedisca l’accesso remoto da Paesi terzi (es. ambienti air-gapped, token di accesso vincolati a una giurisdizione).
- Conformità a normative specifiche: la direttiva NIS2 per le infrastrutture critiche, GDPR per i dati personali, regolamenti settoriali (banche, sanità, difesa).
Esempi di mercato ->
Microsoft Sovereign AI (ottobre 2026) definisce il proprio framework attorno a quattro pilastri: control, choice, flexibility, resilience, con l’obiettivo di garantire che i workload AI restino sotto la giurisdizione del cliente. Fonte: Microsoft Cloud Blog.
Teradata Sovereign AI (ottobre 2026) offre ambienti air-gapped su Google Distributed Cloud, pensati specificamente per governi e organizzazioni che non possono accettare alcuna connettività con infrastrutture esterne. Fonte: Teradata Press Release.
Attenzione al marketing! Il termine “Sovereign AI” non ha ancora una definizione normativa univoca nella legislazione UE. Nella letteratura di policy resta descritto come loosely defined. Un vendor che usa l’etichetta “AI sovrana” potrebbe offrire solo residenza del dato in una cloud region EU, senza alcuna garanzia di isolamento giurisdizionale.
Esecuzione on-premise: quando il modello gira davvero nel vostro data center
Definizione operativa -> L’esecuzione on-premise (o esecuzione locale) significa che l’inferenza — e, a seconda dell’architettura, anche il fine-tuning — avviene su hardware fisicamente presente nei locali del cliente. Nessun byte di prompt, output o log lascia il perimetro fisico dell’organizzazione.
Cosa la distingue dalle altre due.
| Che cosa descrive | Che cosa non garantisce | |
|---|---|---|
| Residenza del dato | La localizzazione geografica della conservazione dei dati. | Assenza di accessi remoti, controllo giuridico esclusivo o localizzazione dell’elaborazione. |
| Sovranità del dato | Il livello di controllo giuridico, tecnico e operativo esercitabile sui dati. | Immunità assoluta da normative estere o da richieste legali di accesso. |
| Esecuzione on-premise | L’esecuzione del sistema AI su infrastrutture locali dell’organizzazione. | Assenza di comunicazioni esterne, sicurezza assoluta o conformità normativa automatica. |
Implicazioni hardware -> I requisiti hardware dei modelli linguistici locali dipendono dal numero di parametri, dall’architettura, dal formato numerico, dalla quantizzazione, dalla lunghezza del contesto e dal numero di richieste concorrenti. Modelli compatti possono essere eseguiti su workstation o dispositivi (come succede per il nostro software AI Gol-IA) con risorse relativamente contenute, mentre sistemi più grandi o destinati a carichi multiutente possono richiedere GPU professionali e infrastrutture dedicate.
Perché la distinzione è decisiva per PA, PMI e studi professionali
Per le Pubbliche Amministrazioni
La direttiva UE 2022/2555 (NIS2), recepita in Italia, impone alle entità essenziali e importanti requisiti di gestione del rischio informatico che includono la protezione delle infrastrutture di calcolo. Un sistema AI che elabora dati di infrastrutture critiche (energia, trasporti, sanità) deve essere valutato alla luce di questi obblighi. La semplice residenza del dato in UE non è sufficiente.
Inoltre, il D.Lgs. 179/2026 (G.U. ottobre 2026), che completa l’implementazione italiana dell’AI Act, designa ACN come autorità di vigilanza per i sistemi AI ad alto rischio e AgID come autorità notificante. Le Pubbliche Amministrazioni che utilizzano sistemi AI devono verificare la classificazione del caso d’uso secondo l’AI Act e individuare gli obblighi applicabili al proprio ruolo.
Per i sistemi ad alto rischio, questi possono comprendere specifiche misure di supervisione, monitoraggio, registrazione e valutazione degli impatti sui diritti fondamentali, ferme restando le responsabilità del fornitore relative alla valutazione di conformità.
Per le PMI
Il regime sanzionatorio dell’AI Act, graduato da 1 milione di euro (o 0,5% del fatturato mondiale) fino a 35 milioni (o 7%), si applica anche ai deployer. Per una PMI che usa un LLM locale per automatizzare la fatturazione o il customer service, il rischio è contenuto se il sistema è a basso rischio. Quando un sistema AI viene impiegato in processi quali la selezione del personale, la valutazione dell’affidabilità creditizia delle persone fisiche o altri ambiti individuati dall’AI Act, occorre verificare se la specifica finalità d’uso rientri fra quelle classificate ad alto rischio. La scelta tra cloud-sovereign e on-premise deve essere guidata dalla classificazione del rischio del caso d’uso, non dal marketing del vendor.
Per gli Studi Professionali
Avvocati, commercialisti, consulenti del lavoro e ingegneri gestiscono dati coperti da segreto professionale. Un LLM locale che elabora atti processuali, bilanci o perizie senza che nessun byte lasci lo studio offre un livello di garanzia che un servizio cloud — per quanto “sovrano” — non può replicare in modo assoluto. La residenza del dato in UE è un prerequisito, non una garanzia.
Come valutare un vendor di AI on-premise: 5 domande da fare
Prima di firmare un contratto o un capitolato, ponete al vendor queste cinque domande. Le risposte devono essere documentate per iscritto, non verbali:
- “Dove avviene fisicamente l’inferenza?” Se la risposta è “in un data center in UE” ma non nel vostro, state valutando residenza del dato, non esecuzione on-premise.
- “Il modello e i dati sono accessibili da remoto da personale del vendor o di sub-processor?” In un deployment on-premise vero, la risposta deve essere “no” (o “solo con accesso fisico autorizzato e loggato”).
- “Sotto quale giurisdizione legale cadono i dati e il modello?” Per sovranità del dato, la risposta deve essere “esclusivamente italiana/UE”, con clausole contrattuali che escludano la portata del CLOUD Act o di normative analoghe di Paesi terzi.
- “Quali sono i requisiti hardware minimi e il TCO a 3 anni?” Chiedete una stima che includa GPU, storage, raffreddamento, manutenzione e licenze. Confrontate con il costo di un equivalente cloud-sovereign.
- “Il sistema è stato sottoposto a penetration test o audit di sicurezza indipendente?” Per PA e settori regolati, la risposta “no” è un segnale di allarme.
Il quadro normativo di riferimento
| Norma | Rilevanza per AI on-premise |
|---|---|
| GDPR (Reg. UE 2016/679) | Obblighi di protezione dei dati personali in qualsiasi deployment, on-premise o cloud. |
| NIS2 (Reg. UE 2022/2555) | Requisiti di sicurezza per infrastrutture critiche; impatta la scelta tra cloud e on-premise. |
| AI Act (Reg. UE 2024/1689) + D.Lgs. 179/2026 | Classificazione del rischio, obblighi di conformità, sanzioni. ACN come autorità di vigilanza. |
| Digital Omnibus (Reg. UE 2026/1744) | Semplificazioni e posticipi parziali per sistemi AI ad alto rischio. |
| CLOUD Act USA (2018) | Rischio di accesso extra-UE per dati su infrastruttura di provider con sede legale USA. |
FAQ
No. “AI locale” può indicare un modello su un laptop o una workstation, senza infrastruttura data center. “AI on-premise” implica un deployment su infrastruttura dedicata (server, GPU, storage) nel data center dell’organizzazione. Entrambi implicano esecuzione locale, ma con scale e requisiti di sicurezza diversi.
Non automaticamente. Un LLM locale mal configurato, senza aggiornamenti di sicurezza, senza controllo degli accessi fisici e senza logging, può essere più vulnerabile di un servizio cloud gestito con certificazioni ISO 27001 e SOC 2. La sicurezza dipende dall’implementazione, non dalla collocazione.
Un LLM locale può essere utilizzato per elaborare dati soggetti a obblighi di riservatezza e segreto professionale, purché il sistema sia configurato e gestito in conformità alle normative applicabili. L’esecuzione locale può contribuire a limitare l’esposizione a fornitori esterni, ma non sostituisce le necessarie misure di sicurezza, le verifiche sui trattamenti e gli obblighi professionali.
La distinzione tra residenza del dato, sovranità ed esecuzione on-premise non è un tecnicismo: è la differenza tra conformità e rischio. E in un contesto normativo che si sta rapidamente consolidando — con l’AI Act già in larga parte applicabile, ulteriori obblighi in arrivo entro il 2028 e il D.Lgs. 179/2026 già in vigore — non è un lusso che PA, PMI e studi professionali possano permettersi di ignorare.