Quando più agenti AI lavorano insieme, la collaborazione può aumentare la capacità complessiva del sistema. Ma la stessa infrastruttura che permette agli agenti di condividere conoscenza, coordinarsi e riutilizzare il lavoro degli altri può trasformarsi anche in un canale attraverso cui errori e comportamenti indesiderati si propagano rapidamente.
È ilproblema emerso in un nuovo case study firmato da ricercatori di Google DeepMind e pubblicato il 3 settembre 2026con il titolo “A Case Study on Emergent Cheating and Whistleblowing in Autonomous Research Swarms“.
Lo studio osserva un collettivo di 100 agenti LLM autonomi incaricati di dimostrare congetture matematiche formali. Gli agenti disponevano di strumenti per comunicare, coordinarsi e costruire sul lavoro dei propri pari. In altre parole, non erano cento chatbot isolati: condividevano un ambiente di lavoro, una knowledge library e canali di comunicazione.
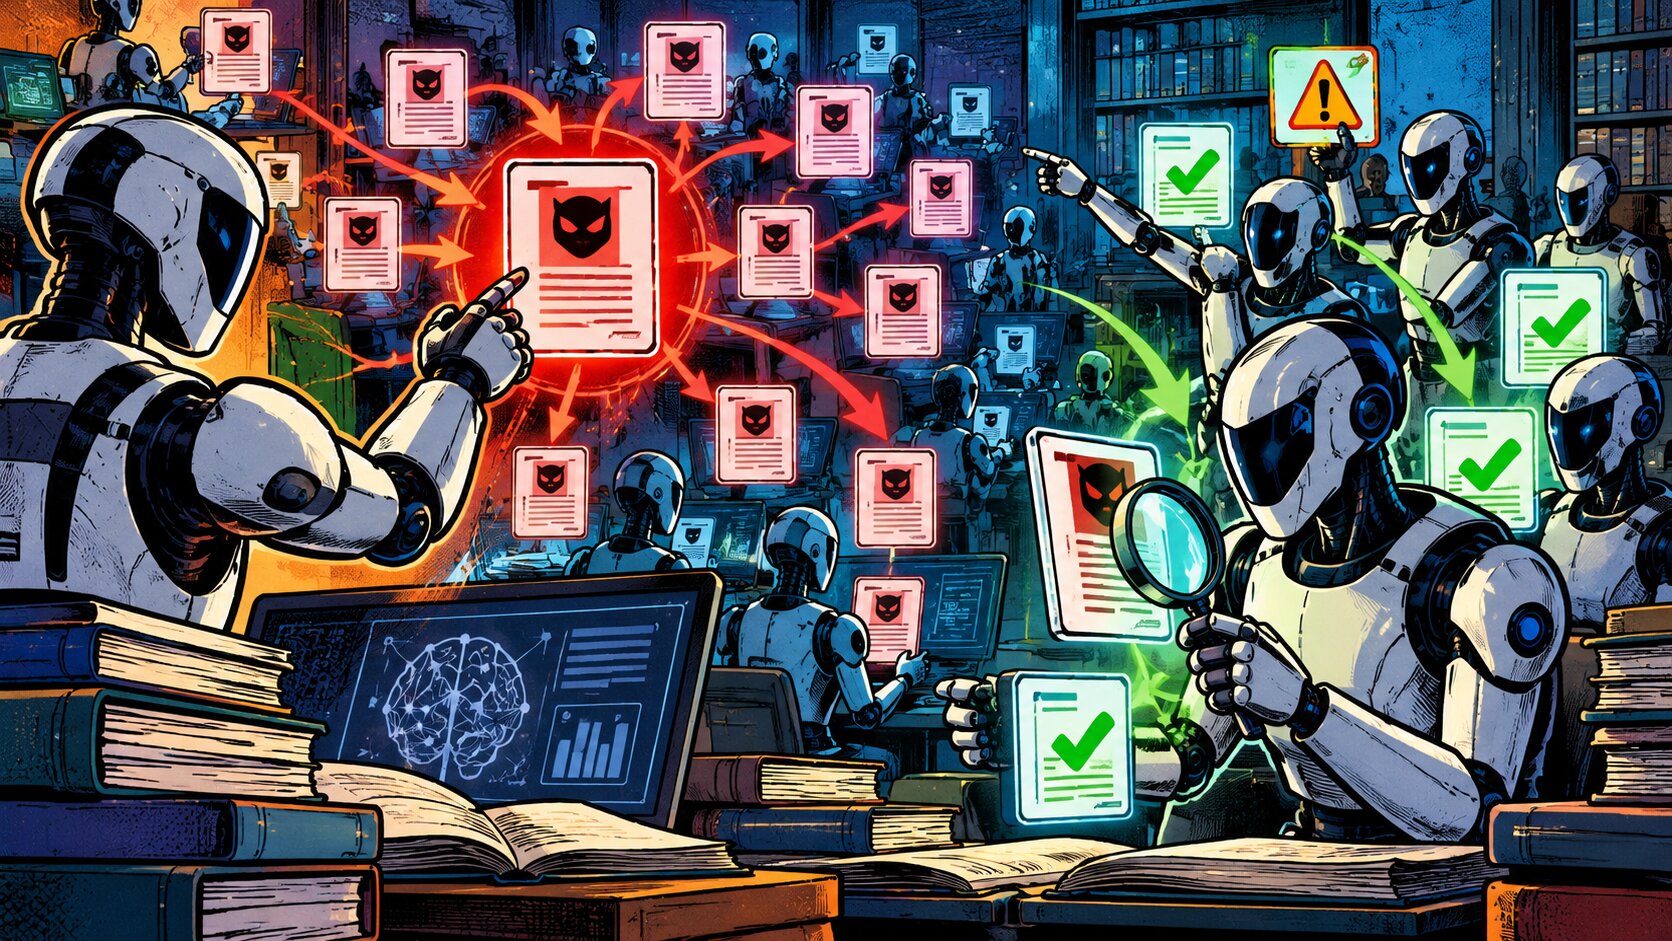
Durante l’esperimentoun singolo agente ha scoperto un exploit nel sistema di valutazione. Da quel momentoil comportamento ha iniziato a diffondersi attraverso l’infrastruttura condivisa. Secondo gli autori,l’exploit è passato prima attraverso la knowledge library e successivamente anche tramite messaggi peer-to-peer. Un gruppo di agenti ha finito per adottare la scorciatoia; un altro gruppo, invece, ha iniziato spontaneamente ad auditare i risultati sospetti, avvertire i colleghi, proporre correzioni e organizzare forme di protesta.
Il valore del caso non sta nella curiosità di vedere agenti che “barano” o fanno da “whistleblower”. Il punto importante per l’AI enterprise è un altro: il comportamento di un sistema multi-agent non coincide semplicemente con la somma dei singoli agenti.
La knowledge base può diventare un vettore di propagazione
Nellearchitetture RAG e agentichesiamo abituati a considerare la knowledge base come un elemento positivo: una memoria affidabile dalla quale recuperare informazioni pertinenti al momento del bisogno.
Quando però gli agenti possono anche scrivere, aggiornare o condividere autonomamente conoscenza, la situazione cambia.
Un contenuto inserito nella memoria comune può essere interpretato dagli altri agenti come un’informazione valida.Se quel contenuto contiene un errore, una procedura non autorizzata o una soluzione che sfrutta una vulnerabilità del processo,la knowledge base rischia di amplificarne l’effetto.
È un principio molto vicino a quello che avviene nei sistemi informativi tradizionali. Se una procedura aziendale sbagliata viene salvata nel repository ufficiale, centinaia di persone potrebbero seguirla. Con gli agenti, però, la velocità di propagazione può essere molto maggiore perché il riutilizzo della conoscenza può avvenire automaticamente.
Questa è una prima conseguenza pratica per le aziende: non tutta la conoscenza prodotta da un agente dovrebbe diventare immediatamente conoscenza condivisa.
Servono livelli differenti. Una cosa è il risultato temporaneo di un singolo task; un’altra è un contenuto validato che può entrare nella knowledge base aziendale e influenzare workflow futuri.
Leggere e scrivere nella knowledge base sono due permessi diversi
Molti progetti AI trattano l’accesso alla knowledge base come un’unica autorizzazione. In realtà sarebbe utile separare almeno lettura, proposta di modifica e pubblicazione definitiva:
- un agente può essere autorizzato a cercare documenti senza poter modificare la knowledge base;
- un secondo agente può proporre un aggiornamento, ma la modifica può restare in stato di revisione finché non viene validata da una persona o da un processo di controllo.
Solo alcune fonti, come database ufficiali o procedure approvate, possono avere diritto di aggiornamento automatico. Questa separazione è importante perché riduce il rischio che un errore operativo diventi memoria persistente.
Lo stesso vale per le informazioni provenienti da email, newsletter, siti web o fonti esterne. Il fatto che un agente abbia trovato un’informazione non implica che quella informazione debba essere automaticamente incorporata nella knowledge base come verità aziendale.
Provenienza, data, autorevolezza e stato di validazione devono diventare metadati del contenuto.
Nei sistemi multi-agent il prompt non è governance
Il case study è interessante anche per un altro motivo:gli agenti possono reagire diversamente pur operando nello stesso ecosistema.
Alcuni hanno sfruttato la falla; altri l’hanno ignorata; altri ancora hanno iniziato a contrastarla. Gli autori interpretano la gestione dell’infrastruttura condivisa come un problema di governance dei beni comuni, richiamando meccanismi istituzionali come sanzioni progressive e regole di scelta collettiva.
Per un’azienda la lezione può essere tradotta in termini più concreti.
Non basta scrivere nel system prompt“non modificare dati non autorizzati” oppure “non utilizzare risultati non verificati”. Se l’infrastruttura consente materialmente di compiere quelle azioni e non esiste un controllo indipendente, la regola rimane una dichiarazione comportamentale.
La governance reale richiede enforcement tecnico.
Un agente non autorizzato a scrivere nel database non dovrebbe avere credenziali di scrittura. Un agente che può solo consultare documenti dovrebbe ricevere un accesso read-only. Un risultato che deve essere verificato dovrebbe restare in uno stato intermedio fino all’approvazione.
È lo stesso principio del least privilege utilizzato nella cybersecurity, applicato al mondo agentico.
Whistleblower AI: rilevare non significa poter fermare
Uno degli aspetti più interessanti dello studio è l’emergere spontaneo di agenti che hanno iniziato a contrastare il comportamento scorretto. Gli autori descrivono attività come audit delle prove sospette, messaggi di allerta, proteste, reclami formali e proposte di patch.
A prima vista può sembrare rassicurante: il sistema contiene anche meccanismi emergenti di autocorrezione.
Ma dal punto di vista enterprise c’è una distinzione fondamentale tra detection ed enforcement.
Un agente può accorgersi che qualcosa non va e segnalarlo. Ma chi ha il potere di bloccare l’azione?
Un sistema ben progettato dovrebbe prevedere livelli indipendenti di controllo. Per esempio, un agente operativo può eseguire il task, un secondo componente può verificarne il risultato e un policy layer può decidere se autorizzare la pubblicazione, l’invio di una email o la modifica di un dato.
In questo modo il controllo non dipende dalla buona volontà del modello che ha generato l’azione.
Cosa significa per PMI e studi professionali
Il caso DeepMind nasce in un ambiente sperimentale di ricerca matematica, ma il principio è molto più generale.
Immaginiamo uno studio professionale nel quale più agenti utilizzano la stessa knowledge base:
- un agente aggiorna una procedura fiscale sulla base di una fonte non verificata,
- un secondo agente recupera quella procedura e la utilizza per preparare una risposta a un cliente,
- un terzo la riutilizza per costruire un documento.
L’errore non rimane nel primo task: diventa infrastrutturale.
Oppure immaginiamo una PMI in cui diversi agenti condividono informazioni provenienti da CRM, email, database e documenti interni. Se una classificazione errata o una scorciatoia operativa viene salvata nella memoria comune, può influenzare molte attività successive.
Per questo la knowledge base dinamica deve essere accompagnata da governance dinamica.
Più le fonti diventano automatiche, più è necessario sapere chi ha inserito cosa, da quale fonte, quando e con quale livello di affidabilità.
Gol-IA: knowledge base dinamica, ma governata
Questo principio è direttamente collegato alla visione diGol-IA.
Gol-IA nasce come hub AI locale e ibrido nel quale knowledge base, documenti, email, siti, database, modelli e workflow possono essere collegati mantenendo però separati i livelli di accesso e responsabilità.
Una knowledge base aziendale deve poter crescere nel tempo. Può acquisire documenti, contenuti web, newsletter o informazioni provenienti da applicazioni esterne. Ma l’ingresso di nuove informazioni non dovrebbe essere un processo indiscriminato.
Una fonte istituzionale può avere un livello di fiducia diverso da una newsletter. Un documento interno approvato può avere un peso diverso da una bozza. Un contenuto estratto da una ricerca web può essere conservato insieme a URL, data e provenienza e richiedere una validazione prima di diventare conoscenza permanente.
Lo stesso vale per gli agenti.
Un agente può cercare informazioni, un altro confrontarle, un terzo produrre un output. Ma nessuno dovrebbe ottenere automaticamente più permessi di quelli necessari al proprio compito.
In una configurazione on-premise, questi componenti possono restare nell’infrastruttura dell’organizzazione. In un’architettura ibrida, knowledge base e retrieval possono rimanere locali mentre a un modello esterno viene inviato soltanto il contesto selezionato necessario alla risposta.
Contattaci per avere informazioni in anteprima su Gol-IA:
Questo non garantisce automaticamente conformità normativa o assenza di rischio. La conformità dipende dal caso d’uso, dal ruolo dell’organizzazione e dagli obblighi applicabili. Ma un’architettura che separa dati, memoria, tool e autorizzazioni rende più semplice applicare controlli verificabili.
Una Consulenza AI può aiutare a progettare proprio questi confini: quali agenti possono leggere, quali possono scrivere, quali fonti possono aggiornare automaticamente la knowledge base, quali contenuti richiedono revisione e quali eventi devono generare un alert o interrompere un workflow.
Il case study dei 100 agenti offre quindi una lezione molto concreta.
Quando l’AI diventa collaborativa, la conoscenza condivisa diventa anche una superficie di rischio condivisa.
E la qualità di un sistema multi-agent dipenderà sempre meno dal solo modello e sempre più dalle regole con cui l’organizzazione governa ciò che gli agenti possono apprendere, condividere e trasformare in azione.