Per molto tempo eseguire modelli AI direttamente in azienda ha richiesto workstation potenti o server dedicati. Una nuova generazione di computer compatti mostra però quanto rapidamente stia cambiando l’hardware disponibile per l’AI locale.
ASUS ha appena annunciato la disponibilità diAscent QN10, un mini PC da 130×130×40 mm basato su Snapdragon X2 Elite, con CPU Oryon fino a 18 core, GPU Adreno e NPU Hexagon capace di raggiungere80 TOPS. ASUS lo indirizza anche a sviluppatori e aziende per AI on-device, edge computing e applicazioni agentiche.

Il dato importante non sono gli 80 TOPS
La NPU può raggiungere 80 TOPS e il sistema supporta fino a 32 GB di memoria LPDDR5X. Attraverso Qualcomm AI Hub, gli sviluppatori possono inoltre accedere a modelli ottimizzati per l’esecuzione direttamente sul dispositivo.
Sarebbe però sbagliato trasformare gli 80 TOPS in una misura universale delle prestazioni con gli LLM.
Dimensione e quantizzazione del modello, memoria disponibile e relativa bandwidth, GPU, NPU e soprattutto supporto del runtime determinano cosa possa realmente essere eseguito e con quali prestazioni.
Il fatto interessante è quindi meno spettacolare, ma strategicamente più importante:l’hardware necessario per portare una parte dell’AI vicino ai dati aziendali sta diventando più piccolo e accessibile.
Da “locale o cloud” a “quale workload dove?”
Qui bisogna distinguere i fatti dall’interpretazione.
Ilfattoè che ASUS progetta il QN10 esplicitamente per AI on-device ed edge computing e cita applicazioni agentiche tra i workload supportati.
Cosa può significare questa evoluzione per le aziende?
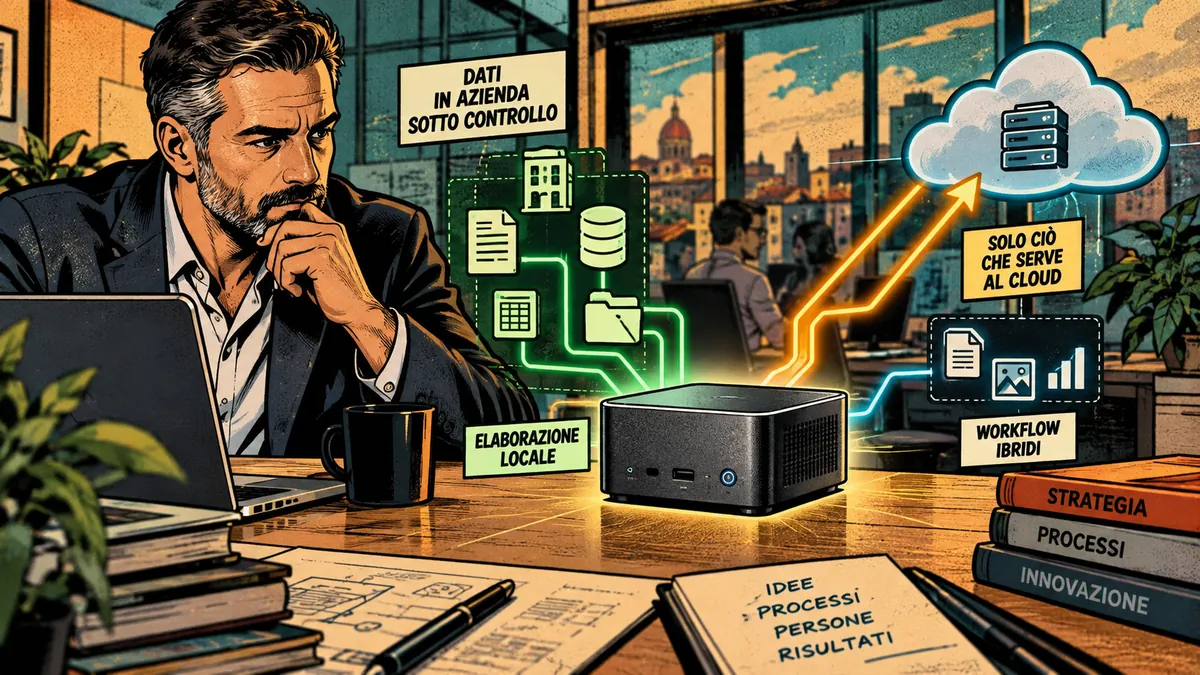
Il dibattito sull’AI potrebbe progressivamente spostarsi dalla contrapposizione “on-premise contro cloud” a una scelta molto più granulare:dove conviene eseguire ogni componente del processo?
Un’organizzazione potrebbe mantenere localmente documenti, embedding, retrieval e alcune elaborazioni compatibili con modelli più piccoli, ricorrendo a modelli cloud più potenti quando una richiesta ne giustifica capacità e costi.
Non tutto deve necessariamente seguire lo stesso percorso.
Perché interessa PMI e Studi Professionali
Sistemi compatti di questa categoria riducono la barriera infrastrutturale per sperimentare AI on-device ed edge. Non sostituiscono automaticamente una workstation o un server GPU e non rendono conveniente qualsiasi workload locale.
Aprono però possibilità interessanti per organizzazioni che devono bilanciare quattro esigenze:controllo dei dati, prestazioni, costi e qualità dei modelli.
La parte difficile diventa allora l’architettura.
Occorre stabilire quali informazioni possano uscire dal perimetro aziendale, quali elaborazioni sia utile mantenere locali, quando utilizzare servizi esterni e come presentare all’utente un’esperienza uniforme anche se dietro le quinte intervengono risorse differenti.
L’AI ibrida diventa così meno una scelta di prodotto e più unastrategia di orchestrazione.
Gol-IAnasce proprio con la possibilità di combinare modelli, knowledge base e workflow mantenendo flessibilità sull’infrastruttura utilizzata. L’obiettivo è scegliere locale, cloud o una combinazione dei due in funzione del processo, non per appartenenza tecnologica.