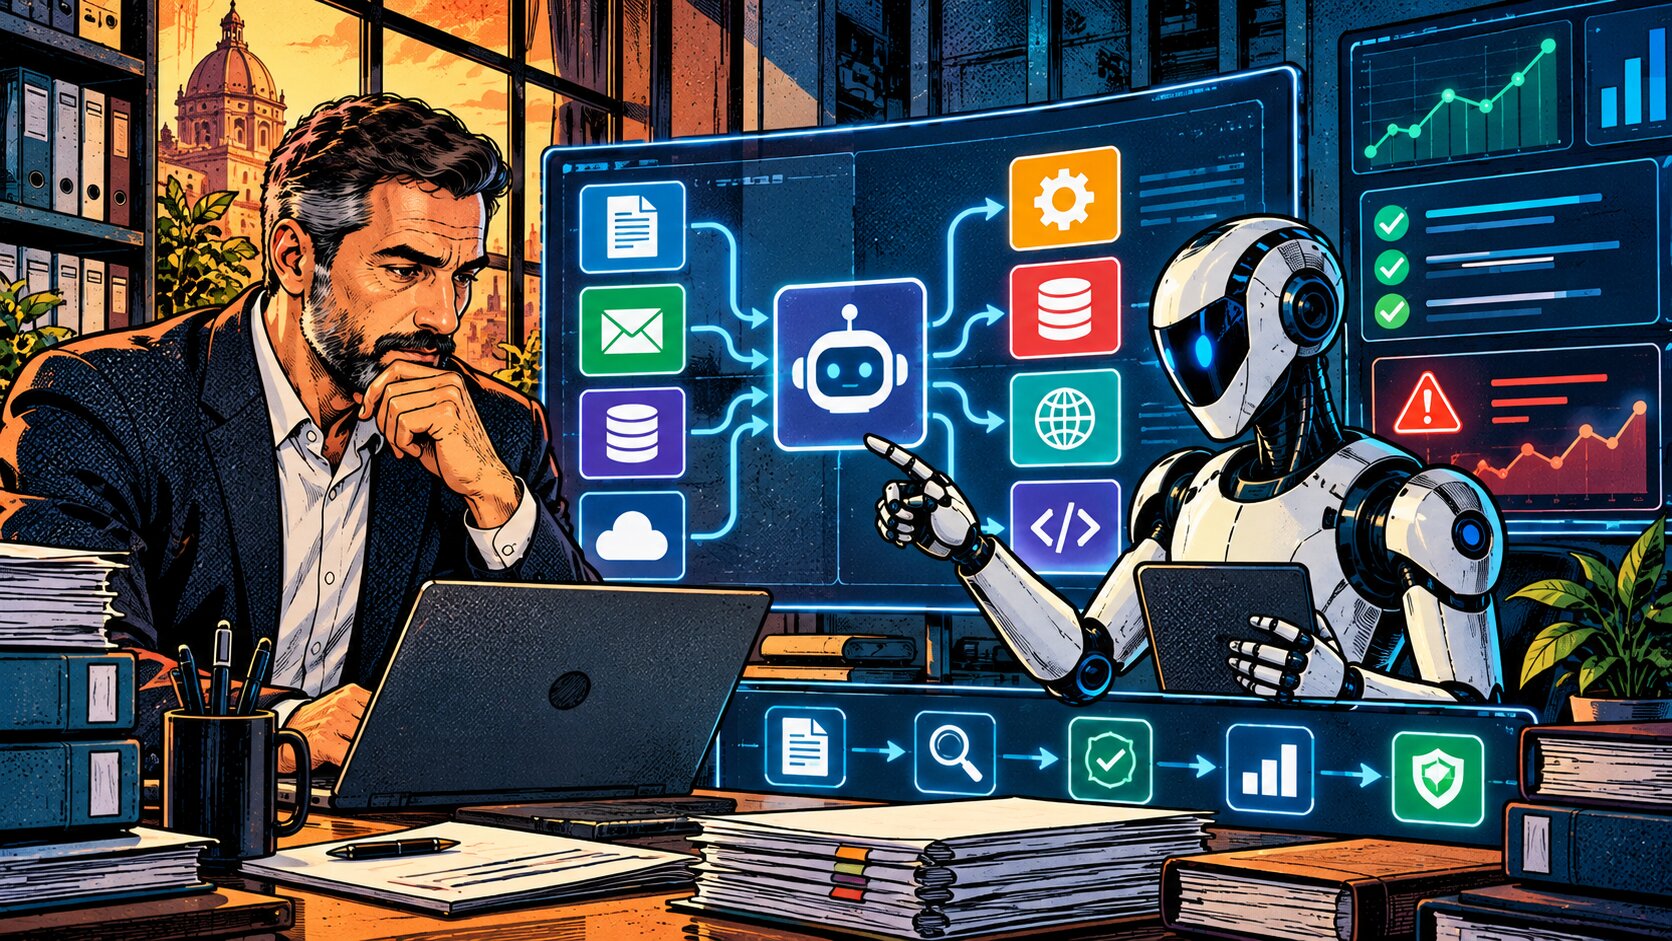
Portare un Agente AI dalla demo alla produzione cambia completamente il problema. Durante un test interno può essere sufficiente verificare che l’agente risponda correttamente a qualche richiesta.
Quando però lo stesso sistema viene collegato a documenti, email, API, database, applicazioni e workflow reali, la domanda non è più soltanto “funziona?”.
Diventa: “come sappiamo che continuerà a funzionare in modo affidabile nel tempo?”
È il tema affrontato da n8n nell’articolo pubblicato l’8 settembre 2026, AI Agent Reliability: Debug, Evaluate, and Monitor in Production.
La tesi è molto concreta
Un agente può apparire ben progettato perché utilizza il modello corretto, un buon prompt e qualche guardrail, ma questo non permette automaticamente di capire dove si rompe la logica quando il risultato diventa incoerente. Per farlo servono strumenti e processi che permettano di osservare il comportamento dell’agente durante l’intero ciclo di vita.
Dalla demo alla produzione cambia la natura dell’errore
In un chatbot sperimentale una risposta sbagliata può essere semplicemente scartata. In un agente operativo le conseguenze sono diverse. Un sistema può recuperare il documento sbagliato, utilizzare un tool non appropriato, interpretare male un dato proveniente da un’API o passare un’informazione errata a uno step successivo del workflow.
Quando l’agente dispone di strumenti, ogni passaggio diventa quindi parte del comportamento da controllare.
n8n propone un ciclo composto da cinque aree:
- reliability,
- debugging,
- evaluation,
- metriche,
- monitoring.
Non sono cinque problemi indipendenti. Formano una catena.
Prima si definiscono i controlli che limitano il comportamento dell’agente. Poi si costruiscono strumenti per capire cosa sia successo quando qualcosa non funziona. Gli errori reali diventano casi di test. I test producono metriche. Le metriche vengono osservate nel tempo per individuare regressioni o cambiamenti di comportamento.
Questo approccio porta l’AI molto più vicino alle pratiche di software engineering rispetto alla semplice prompt engineering.
Il contesto conta quanto il modello
Uno dei punti più interessanti dell’articolo n8n riguarda l’origine degli errori. Secondo la guida, molti problemi derivano da ciò che l’agente riceve come contesto più che dalle sole capacità del modello.
Un agente può ragionare perfettamente su informazioni sbagliate. Può ricevere documenti non aggiornati, dati incompleti, una cronologia di conversazione eccessivamente lunga o risultati provenienti da un tool che non sono stati validati.
Per una piattaforma aziendale questo significa che la quality assurance non può fermarsi all’LLM.
Bisogna controllare:
- il retrieval,
- la selezione delle fonti,
- i parametri con cui vengono chiamati gli strumenti,
- il modo in cui i risultati vengono trasferiti da uno step all’altro.
Guarda caso, esattamente quello che fa Gol-IA!
In un sistema RAG, per esempio, può essere utile registrare quali documenti sono stati recuperati per una risposta. In un workflow collegato alla posta elettronica può essere importante sapere quale messaggio ha originato una decisione. In un agente che interroga un database, può essere necessario tracciare query, risultati e permessi utilizzati.
L’affidabilità nasce quindi dall’intera catena del contesto, non solo dal modello generativo.
Debuggare un agente significa ricostruire la sua esecuzione
Un workflow tradizionale tende a fallire in modo esplicito: un’API restituisce un errore, una connessione scade oppure un nodo non riesce a elaborare il dato.
Un agente AI può invece completare il workflow e produrre un risultato formalmente valido ma semanticamente sbagliato.
Questo rende il debugging più difficile.
n8n suggerisce di poter individuare l’esecuzione corretta tra molte run e ricostruire ciò che l’agente ha ricevuto e prodotto a ogni passaggio. La piattaforma utilizza execution tagging e ispezione completa di input e output; per analisi più profonde vengono citati anche strumenti esterni come LangSmith o LangFuse, quest’ultimo utilizzabile anche in scenari self-hosted.
L’obiettivo è passare da “l’agente ha sbagliato” a una diagnosi molto più precisa: il problema era nel retrieval, nel prompt, nel tool, nella risposta dell’API, nella memoria, nel modello o nella logica di routing?
Senza questa visibilità, ogni correzione rischia di essere un tentativo casuale.
Ogni modifica dovrebbe avere una valutazione
Un altro punto centrale riguarda l’evaluation:
- cambiare una riga del prompt può migliorare alcuni casi e peggiorarne altri;
- cambiare modello può ridurre il costo ma introdurre errori su task specifici;
- aggiungere un nuovo tool può ampliare le capacità dell’agente ma creare nuove possibilità di comportamento inatteso.
Per questo n8n raccomanda di costruire un dataset di test rappresentativo dei percorsi critici e di eseguire valutazioni ogni volta che cambia un prompt, un tool o un modello.
La guida suggerisce inoltre di aggiungere al dataset di test i fallimenti osservati realmente in produzione, combinando valutazioni offline e online.
È un principio molto vicino ai test di regressione del software.
Gli errori osservati in produzione non dovrebbero essere semplicemente corretti e dimenticati. Dovrebbero diventare nuovi casi di test, così da verificare che lo stesso problema non venga reintrodotto successivamente.
Per un’azienda questo approccio permette di costruire una memoria tecnica dell’affidabilità del sistema.
Non basta misurare quanti workflow finiscono
Anche la scelta delle metriche è importante.
n8n divide gli indicatori in quattro categorie: execution, quality, efficiency e safety. La guida sottolinea inoltre che ha senso monitorare soprattutto le metriche capaci di modificare una decisione operativa.
Questa distinzione aiuta a evitare un errore frequente: considerare affidabile un agente soltanto perché il workflow termina senza errori tecnici.
Un’esecuzione può essere completata e produrre comunque un risultato di scarsa qualità.
Per questo può essere utile misurare tasso di successo, qualità dell’output, latenza, consumo di token, costo, frequenza degli interventi umani e violazioni dei guardrail.
Le metriche devono però servire a una decisione concreta. Se un numero non porta a nessuna azione, rischia di diventare semplicemente rumore.
Il comportamento dell’agente AI cambia nel tempo
Un agente non opera in un ambiente statico.
Anche senza modificare il prompt, possono cambiare gli utenti, i dati, le API, la lunghezza delle conversazioni e le fonti esterne. Una knowledge base dinamica può acquisire continuamente nuovi contenuti.
n8n sottolinea infatti che gli output possono spostarsi nel tempo anche senza un cambio esplicito del modello o del prompt, proprio perché cambiano pattern degli utenti, API e stato della conversazione.
Il monitoring serve quindi a osservare sia la salute operativa sia il comportamento dell’agente.
Per un sistema aziendale è importante poter distinguere, per esempio, un aumento della latenza da un deterioramento della qualità, oppure un problema nel provider LLM da un cambiamento nella distribuzione dei dati in ingresso.
Questo livello di osservabilità è particolarmente importante quando gli agenti svolgono attività ripetitive senza una persona davanti allo schermo.
Cosa significa per PMI e studi professionali
Per una PMI o uno Studio Professionale, tutto questo può sembrare inizialmente eccessivo. In realtà diventa necessario proprio quando si vuole affidare all’AI un’attività che produce valore reale.
Un agente che riassume una newsletter può tollerare una certa variabilità. Un agente che prepara una risposta per un cliente, analizza documenti contrattuali o aggiorna informazioni in un gestionale richiede un livello diverso di controllo.
Non tutti i workflow devono avere la stessa infrastruttura di monitoring. Il livello di osservabilità deve essere proporzionato al rischio e alle conseguenze dell’azione.
Questo permette anche di automatizzare di più, non di meno. Quando un’organizzazione sa come verificare, misurare e interrompere un workflow, può delegare attività con maggiore fiducia.
Gol-IA: dall’accesso al modello al governo del sistema
È precisamente il tipo di problema che Gol-IA vuole affrontare.
Gol-IA nasce come hub AI locale e ibrido nel quale modelli, knowledge base, documenti, email, siti, database, utenti e workflow possono essere collegati senza trasformare tutto in un’unica scatola nera.
L’obiettivo è poter sapere quale modello ha elaborato un task, quale contesto gli è stato passato, quali fonti sono state utilizzate e quali strumenti sono stati invocati.
Contattaci per avere informazioni in anteprima su Gol-IA:
Una configurazione può utilizzare modelli locali open source per task ripetitivi o dati sensibili e ricorrere a modelli esterni quando la complessità lo richiede. Knowledge base e retrieval possono restare nell’infrastruttura dell’organizzazione e inviare al modello esterno soltanto il contesto strettamente necessario.
Questo non rende automaticamente un sistema conforme a una normativa né elimina il rischio. Permette però di progettare controlli più granulari e ridurre l’opacità operativa.
La lezione dell’articolo n8n è quindi semplice ma importante: un agente AI non diventa enterprise perché utilizza un modello più potente.
Diventa realmente utilizzabile quando l’organizzazione può capire come lavora, misurarne la qualità, diagnosticare gli errori e accorgersi quando il comportamento cambia.
Il futuro dell’AI aziendale non sarà fatto soltanto di agenti più capaci. Sarà fatto di sistemi che permettono di fidarsi di loro perché sono osservabili, testabili e governabili.